假設你經營一家十幾人的店,要排年度預算。你把營收、人手和競爭狀況打字丟給 AI,幾秒後收到五條編號清楚、理由完整的建議:調降主力商品價格、加碼廣告、擴充菜單、推會員點數、延長營業時間。五條都說得通,預算只夠做兩條,你卻說不準該挑哪兩條。
MIT Sloan Management Review 在 2026 年 4 月 20 日刊出〈How AI Helps the Best and Hurts the Rest〉,介紹 Nicholas Otis 等五位研究者(來自 UC Berkeley Haas、Harvard Business School 與 Columbia Business School)在肯亞做的隨機實驗。完整論文發表於 Management Science(2026 年 7 月 10 日),本文數字以期刊版為準。讀完可以做兩件事:用一張檢查表篩 AI 的建議,再挑一個問題,同時問 AI 與一位真人。
同一位 AI 顧問,為什麼績效弱的老闆少賺近 10%,強的可能多賺 15%?
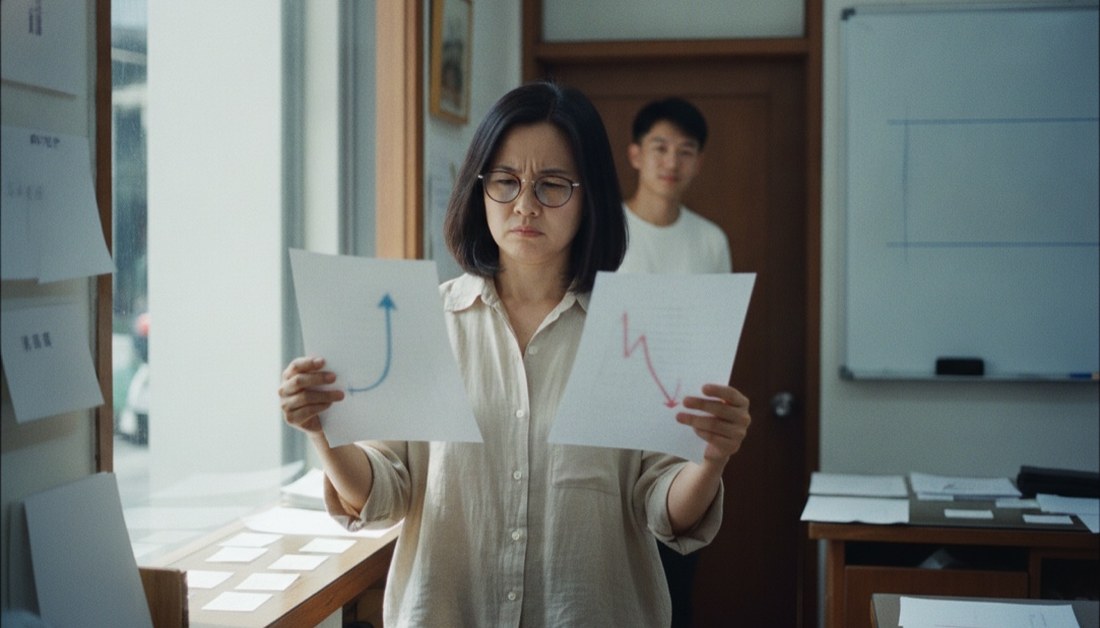
實驗對象是 640 位肯亞小企業主,隨機一半取得 WhatsApp 上的 GPT-4 顧問,另一半拿到商業指南當對照。全體平均看不出差異,但依實驗前的績效分成兩半,方向相反:低於中位數的一半,營收與獲利比對照組低近 10%;高於中位數的一半,可能高出 15% 以上。
研究在 2023 年 5 月下旬到 11 月上旬進行,AI 顧問是 OpenAI 於 2023 年 3 月發佈的 GPT-4,每題回覆三到五條編號建議並附簡短說明。使用 AI 的受試者開始前看過 5 到 10 分鐘的介紹,內容包括它是 AI、資訊可能過時、建議可能不準。對照組拿到國際勞工組織(ILO)為小企業編的商業訓練指南連結,研究者記錄到他們很少使用,因此視為安慰劑。
| 受試者 | 營收與獲利,相對對照組 | 統計上的把握 |
|---|---|---|
| 全部 640 人 | 平均看不出差異 | 無顯著差異(p = 0.32) |
| 實驗前績效低於中位數 | 低近 10% | 有證據(p < 0.01) |
| 實驗前績效高於中位數 | 可能高出 15% 以上 | 僅屬暗示(p = 0.07) |
- 口徑:績效指標合併每週與每月的營收、獲利,全為受試者自填;數字是和對照組比,不是和自己實驗前比。作者用對照組月營收的標準差換算,弱績效組的月營收約低 8%、強績效組約高 18%,這是估計值,強績效組那一端的 95% 信賴區間含零;弱績效組的其他指標約低 10%。MIT SMR 摘要寫成營收與獲利增加 15%,語氣比論文肯定。
- 兩組之間的差距有統計證據(p = 0.01)。文字分析看不出兩組問的題目與收到的建議有差別,作者推論差別出在挑了哪些建議去做。
- 樣本是肯亞的微型事業,餐飲、服飾與農業是大宗,受試者平均約 26 歲,平均月獲利約 19,550 先令(約 137 美元),數字不能直接當成其他市場的預期值。
這個方向和先前的窄任務實驗相反。Brynjolfsson 等人追蹤 5,179 位客服人員,AI 讓整體效率提高 14%,新手與低技能者提高 34%,資深者幾乎沒變;Dell’Acqua 等人讓 758 位 BCG 顧問做 AI 擅長範圍內的任務,原本在平均以下的人進步 43%,平均以上的人進步 17%。作者認為差別在任務:經營事業是開放問題,得自己判斷哪條建議值得做。2024 年 2 月的工作稿曾把原因歸給弱績效組問了較難的題目,期刊版重新分析後,兩組的題目、AI 的回覆與照著做的程度都看不出差別。
老闆用 AI 顧問的五個 Don’t:從照單全收到拿 15% 當預期報酬
老闆用 AI 顧問有五件事不要做:整份建議照單全收、優先做降價與加廣告這類通用招式、把風險提醒當防線、以為用得熟就等於判斷得準,以及拿 15% 當自己的預期報酬。每一件都有研究看到的現象當依據,推論的部分會另外標明。
- Don’t 1:整份建議照單全收:研究中兩組照著 AI 建議行動的程度相近(以經營調整與 AI 建議的相似度衡量),作者寫到,績效弱的受試者看起來高度順從,即使建議可能傷害績效。Dell’Acqua 等人在論文裡也提到,大型語言模型有產出「錯誤卻看似合理」結果的傾向;他們另外挑一題刻意設在 AI 能力範圍外的任務,用 AI 的顧問答對機率比沒用的低 19 個百分點(對照組答對約 84.5%)。
- Don’t 2:優先做降價、加廣告這類通用招式:實驗後的問卷請受試者描述做過哪些經營調整,使用 AI 的弱績效受試者提到降價或廣告的比例,比弱績效的對照組高 11.9 個百分點(p < 0.05),績效強的受試者沒有這個差別。作者推測這類換哪家店都能用的通用招式,可能壓低營收、推高成本,研究沒有單獨檢驗哪一招造成損失。
- Don’t 3:把「AI 可能不準」的提醒當防線:使用 AI 的受試者開始前都看過 5 到 10 分鐘的介紹,內容就包括這類說明,績效弱的一組結果仍低於對照組。研究沒有設「不提醒」的對照,提醒本身有沒有用,這項研究無法回答。
- Don’t 4:以為用得熟就等於判斷得準:2024 年 2 月工作稿的註腳寫到,約三分之一受試者實驗前每週至少用一次 ChatGPT;期刊版沿用這個定義,預先登記檢查這群人的效果是否不同,沒有發現差別。本文的推論是,用得熟不保證挑得準,使用頻率不能代替對每條建議的判斷。
- Don’t 5:拿 15% 當自己的預期報酬:強績效組的增幅只是暗示,95% 信賴區間含零,作者也承認檢定力有限,這組的結果可能來自抽樣變異。McKenzie 2021 年整理的統合分析中,小企業訓練平均讓利潤與銷售額增加約 5% 到 10%;作者在期刊版註腳寫到,這套 AI 顧問每位受試者的成本只有幾美元,多數培訓計畫則要數百美元。5% 到 10% 是培訓的參照值,AI 顧問沒有現成的保證值。
老闆用 AI 顧問的五項 Do:把建議拆開、驗證、再放大
五項 Do 對應前面的五個 Don’t:一次只試一條建議、優先挑貼合自家限制的、動手前寫好指標與停損點、同一個問題再問一位真人,以及用自己的數字驗證。每項分成「研究看到」與「建議做法」兩段,建議做法是本文的建議,不是作者的結論。
| Don’t | Do |
|---|---|
| 整份建議照單全收 | 拆開,一次只試一條 |
| 優先做通用招式 | 先挑貼合自家限制的 |
| 風險提醒當防線 | 動手前寫好停損點 |
| 用得熟就相信 | 同一題再問一位真人 |
| 拿 15% 當預期 | 用自己的基準數字驗證 |
- Do 1:把建議拆開,一次只試一條:研究看到強弱兩組照著 AI 建議行動的程度相近,作者推論結果差在挑了哪些建議。建議做法:AI 一次給三到五條,就挑一條試,其餘留在清單上。
- Do 2:先挑貼合自家限制的建議:研究看到使用 AI 的強績效受試者,描述的調整比對照組具體,例如處理停電、開新的收入來源,也更常提到是和 AI 一起做的。建議做法:每條建議先問「換一家店也成立嗎」,成立的先擱置,再把你的現金、人手與客群(去掉客戶與員工的個資)告訴 AI,要它改寫成只適用你家的版本。
- Do 3:動手前寫好指標、期限與停損點:這一項研究沒有測試,是建議做法。每條要試的建議,先寫下看哪個數字、觀察幾週、掉到哪個數字就停。數字可以選毛利、客單價或回客率;指標要量成果,不要只量用了幾次 AI,可參考AI KPI 該衡量的從來不是用得多。
- Do 4:同一個問題再問一位真人,並排比對:研究沒有比較 AI 與真人顧問,2024 年工作稿也提醒,過去的小企業培訓研究多半沒有依基準績效分組報告結果,真人指導是否也有類似落差仍是未知。建議做法:真人的意見同樣要檢查,所以兩份答案並排,重疊的建議先看,只有 AI 提到的追問「前提是什麼」。
- Do 5:用自己的基準數字驗證,不拿別人的百分比:研究先蒐集三輪實驗前的營收與獲利當基準,再比較實驗後的變化。建議做法:試之前連續記下幾週的營收、毛利與客數,試完對照同一組數字,並寫下同期的其他變動,例如旺季與促銷;先看清自己的基準再決定要不要放大,這個順序可對照先學會對標。
老闆自我檢查表:一條 AI 建議動手前先過這五題
一條 AI 建議值不值得動手,動手前問五題:換一家店也成立嗎、成立的前提是什麼、怎麼知道有效、真人怎麼看,以及賭上多少現金。任何一題答不出來,這條建議先放回清單,不排進預算。
| 問自己 | 紅燈訊號 | 先做什麼 |
|---|---|---|
| 換一家店也成立嗎? | 答案是「成立」 | 要求 AI 依自家限制重寫 |
| 它需要什麼前提? | 說不出前提 | 追問「什麼條件下會失敗」 |
| 做完怎麼知道有效? | 沒有指標與停損日 | 先寫指標、期限、停損點 |
| 真人怎麼看? | 意見相反 | 找出分歧在哪個前提 |
| 賭上多少現金? | 一次動到大半現金 | 縮成小範圍的試行 |
前兩題對應研究看到的通用與貼合差別,後三題是建議做法。以智谷的三支柱內容框架來看,這題一半在 AI(怎麼問),一半在管理(要不要做)。研究沒有測試訓練能不能補上挑選建議的功夫,作者把它列為待回答的問題;在有答案之前,可以先用這張表把檢查動作固定下來,並對照重新定義 AI 素養的核心價值的觀點。檢查動作若只在課堂上講過一次,回到現場容易被忙碌蓋掉,原因可看員工上完 AI 課,回去什麼都沒改變;想讓幹部一起練這個動作,可以參考企業 AI 應用力培訓方案怎麼規劃。
第一步:同一個問題問 AI,也問一位真人,並排比對
第一步是挑一個你正在猶豫的決定,寫三行情境,把同一份題目交給 AI 和一位真人,再把兩份答案並排比對。重疊的建議優先考慮,只有 AI 提到的追問前提,最後只選一條,寫好指標與停損點再動手。
| 步驟 | 做什麼 | 留下什麼 |
|---|---|---|
| 1 | 寫三行情境:現金、人手、客群 | 一份題目 |
| 2 | 同一份題目問 AI,也問一位真人 | 兩份答案 |
| 3 | 標出「兩邊都有」與「只有 AI 有」 | 一張對照表 |
| 4 | 只選一條,寫好指標、期限、停損點 | 一個小實驗 |
挑決定時,選一個做錯了也扛得起、但常常碰到的:進貨量、促銷折扣、要不要多排一個人。要向合夥人或董事會交代時,一句話就夠:研究裡強績效組的增幅只是暗示,弱績效組的下降有統計證據,所以我們先試一條,並寫好停損點。先做步驟 1,把三行情境存進手機備忘錄,再約那位真人聊十五分鐘。
FAQ
常見誤解:這項研究證明 AI 顧問會害績效弱的公司?
只能說在這個樣本裡成立,不能推到所有公司。隨機分派讓弱績效組(實驗前績效低於中位數的一半)較差的結果可以歸因於 AI 顧問,但資料來自自填問卷,只涵蓋肯亞、五個月與單一版本的 AI。至於原因,作者推論是挑選建議的差別,也寫明執行力道、對複雜度的容忍度與時間視野等其他解釋無法完全排除。
營收低的老闆,就代表判斷力差嗎?
不代表。研究用營收與獲利把受試者分成高低兩半,沒有直接測量判斷力;差別在選擇與執行,是作者讀完受試者描述的經營調整後提出的偏好解釋。營收低也可能是剛開業或現金吃緊,檢查表看的是每一條建議,別拿它替自己貼標籤。
現在的 AI 模型已經更新了,這些結論還成立嗎?
目前無法回答。實驗用的是 2023 年 5 月到 11 月的 GPT-4,搭配簡短的系統提示與短暫的使用說明;作者寫到,改進提示、微調模型或加強使用訓練,都可能放大強績效組的好處、減輕弱績效組的傷害。這項研究沒有測試較新的模型,不能用來評價現行的任何一款。
找不到真人可以比對時怎麼辦?
退而求其次,找一位了解你現金、人手與客群的人,內部幹部、會計師、同業朋友都可以,請對方指出 AI 沒看到的前提。連這樣的人都找不到時,就把建議縮成最小的一次試行,先寫好停損點,結果出來再決定要不要放大。
哪些事可以直接交給 AI,哪些要先過檢查?
範圍明確的工作,先前的實驗發現效率提升,而且原本表現較弱的人進步較多,例如客服回覆與顧問式分析(Brynjolfsson 等人、Dell’Acqua 等人)。經營決策是開放問題,建議要由你挑選與執行,適合先過前面的檢查表。
關於智谷
智谷網絡(Kvalley Network)自 1996 年創立,專注企業 AI 轉型與中高階主管培訓,累計服務 3,000+ 家企業、75,000+ 小時訓練執行時數、年度訓練 30,000+ 人次。
研究來源
- Otis 等人 2026〈The Uneven Impact of Generative Artificial Intelligence on Entrepreneurial Performance: Evidence from a Field Experiment in Kenya〉,Management Science(2026 年 7 月 10 日)
- MIT Sloan Management Review 2026〈How AI Helps the Best and Hurts the Rest〉,Otis 等人(2026 年 4 月 20 日)
- Otis 等人 2024〈The Uneven Impact of Generative AI on Entrepreneurial Performance〉工作稿(2024 年 2 月版),NBER 研討會論文集
- Brynjolfsson、Li、Raymond 2023〈Generative AI at Work〉,NBER Working Paper 31161(5,179 位客服人員)
- Dell’Acqua 等人 2023〈Navigating the Jagged Technological Frontier〉,Harvard Business School Working Paper 24-013(758 位 BCG 顧問)
- David McKenzie 2021〈Small business training to improve management practices in developing countries〉,Oxford Review of Economic Policy 37(2)